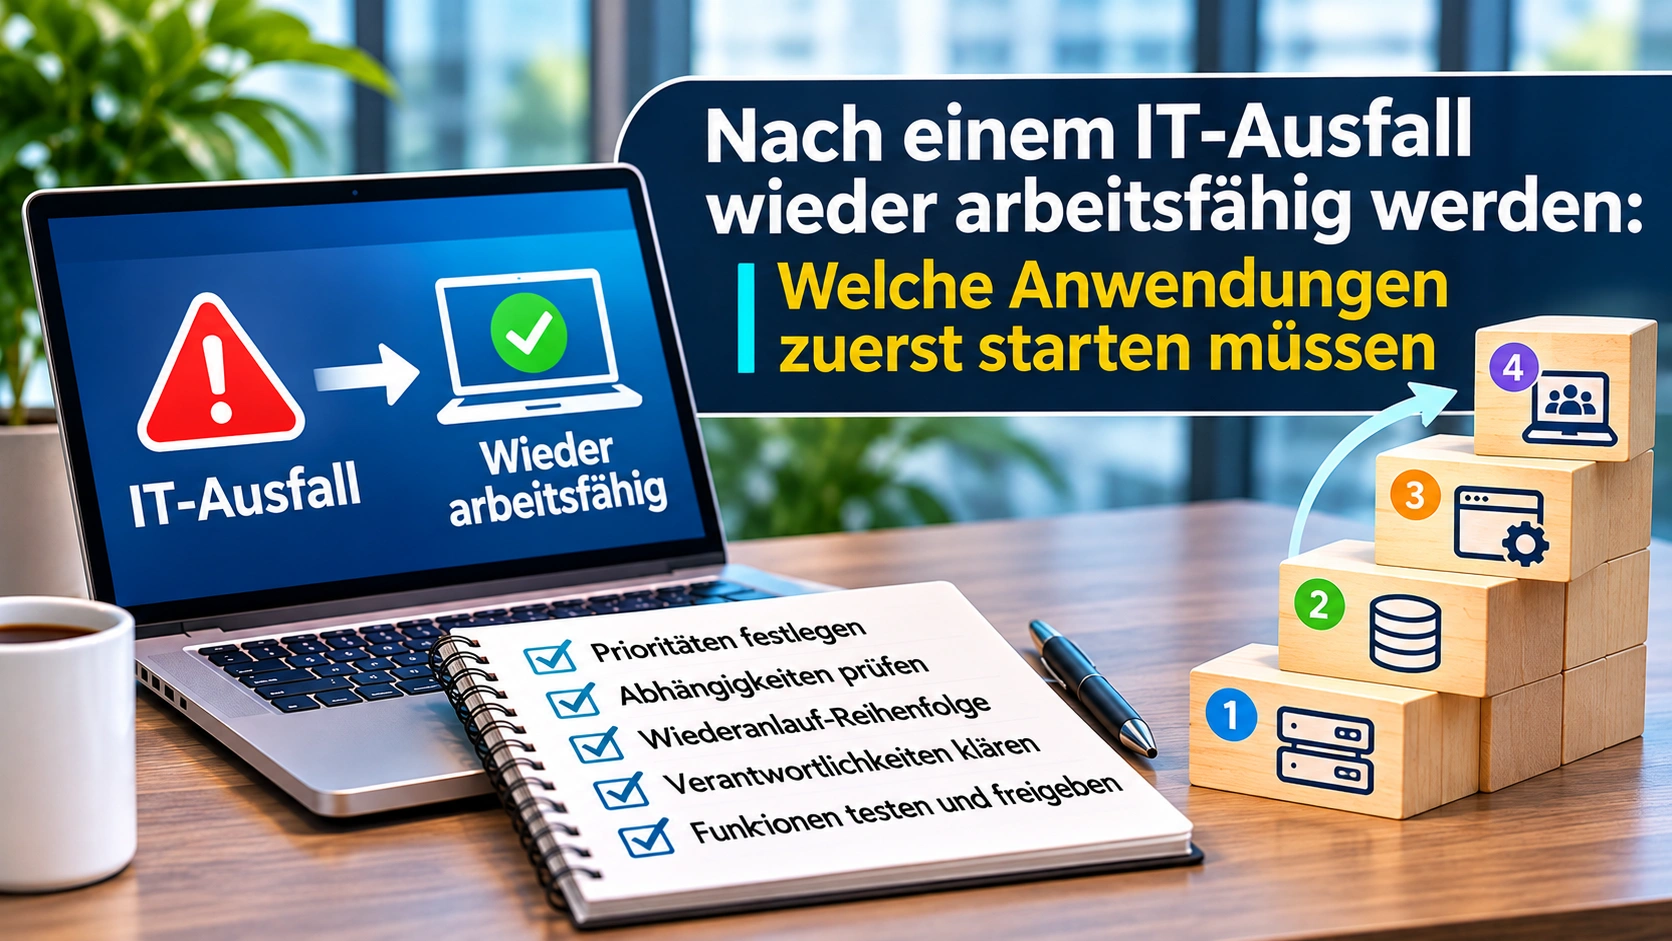
Nach einem IT-Ausfall wieder arbeitsfähig werden – Welche Anwendungen zuerst starten müssen
Der zentrale Server ist ausgefallen. Die Auftragsbearbeitung steht still, Mitarbeiter können sich nicht mehr an bestimmten Anwendungen anmelden und im Lager lassen sich keine neuen Versandaufträge bearbeiten.
Die IT-Abteilung beginnt mit der Wiederherstellung. Doch schon nach kurzer Zeit stellt sich eine entscheidende Frage: Welches System muss zuerst wieder funktionieren?
Soll der E-Mail-Dienst priorisiert werden, weil Kunden auf Antworten warten? Muss das ERP-System zuerst verfügbar sein, damit neue Aufträge bearbeitet werden können? Oder ist zunächst eine Datenbank erforderlich, ohne die sich mehrere Anwendungen überhaupt nicht starten lassen?
Nach einem größeren IT-Ausfall reicht es nicht, möglichst viele Server gleichzeitig wieder einzuschalten. Entscheidend ist die richtige Wiederanlaufreihenfolge – abgestimmt auf die wichtigsten Geschäftsprozesse und ihre technischen Abhängigkeiten.
Ein gut vorbereiteter Wiederanlaufplan hilft Unternehmen dabei, Prioritäten zu setzen, Zuständigkeiten zu klären und die Rückkehr zum Geschäftsbetrieb kontrolliert zu organisieren.
Dieser Artikel zeigt, wie sich kritische Anwendungen identifizieren lassen, warum technische Dienste und Geschäftsprozesse getrennt betrachtet werden müssen und wie ein überprüfbarer Wiederanlaufplan entsteht.
Warum nach einem IT-Ausfall nicht alle Systeme gleichzeitig starten sollten
Wenn zentrale IT-Systeme ausfallen, entsteht verständlicherweise der Wunsch, so schnell wie möglich zum Normalbetrieb zurückzukehren.
Eine unkoordinierte Wiederherstellung kann jedoch zusätzliche Probleme verursachen.
Manche Anwendungen benötigen bestimmte Datenbanken, Identitätsdienste oder Netzwerkverbindungen. Andere Prozesse greifen auf gemeinsame Speicherorte zu oder sind auf externe Cloud-Dienste angewiesen.
Wird eine Anwendung gestartet, bevor ihre Voraussetzungen wieder funktionieren, kann sie weiterhin Fehlermeldungen anzeigen.
Unter ungünstigen Umständen können unkontrollierte Wiederanlaufversuche sogar zu zusätzlichen Inkonsistenzen führen – etwa wenn mehrere Systeme mit unterschiedlichen Datenständen arbeiten.
Die zentrale Frage lautet deshalb nicht:
Welcher Server lässt sich am schnellsten wiederherstellen?
Sondern:
Welche Geschäftsprozesse müssen zuerst wieder nutzbar sein, und welche technischen Komponenten werden dafür benötigt?
Die Antwort kann je nach Unternehmen unterschiedlich ausfallen.
Für einen Onlinehändler ist die Bestellabwicklung möglicherweise besonders kritisch. Für einen produzierenden Betrieb können Fertigungssteuerung und Lagerverwaltung im Vordergrund stehen. In einer Dienstleistungsorganisation sind möglicherweise Kundenkommunikation und der Zugriff auf Projektinformationen entscheidend.
Eine universelle Reihenfolge für alle Unternehmen gibt es nicht.
Geschäftskritische Anwendungen anhand ihrer Auswirkungen priorisieren
Ein Wiederanlaufplan beginnt nicht im Serverraum, sondern bei den Geschäftsprozessen.
Die Geschäftsführung und die Fachabteilungen müssen zunächst klären, welche Tätigkeiten bei einem längeren Ausfall erhebliche Folgen haben.
Dazu gehören beispielsweise unterbrochene Kundenleistungen, Produktionsstillstände, nicht bearbeitete Aufträge oder gesetzliche und vertragliche Verpflichtungen.
Business Impact Analysis als Grundlage
Mit einer Business Impact Analysis (BIA) werden die Auswirkungen einer Unterbrechung systematisch untersucht.
Dabei wird unter anderem bewertet, welche Geschäftsprozesse besonders zeitkritisch sind, welche Ressourcen sie benötigen und wie sich die Folgen eines Ausfalls mit zunehmender Dauer entwickeln.
Der BSI-Standard 200-4 beschreibt die BIA als wesentlichen Bestandteil des Business Continuity Managements.
Für Unternehmen bedeutet das: Die Wiederanlaufpriorität sollte nicht allein danach vergeben werden, welche Abteilung am lautesten nach ihrer Anwendung fragt.
Welche Fragen sollten die Fachbereiche beantworten?
Für jeden wichtigen Geschäftsprozess sollten mindestens folgende Fragen geklärt sein:
- Welche Tätigkeit kann bei einem Ausfall nicht mehr durchgeführt werden?
- Welche Kunden, Mitarbeiter oder Partner sind betroffen?
- Welche rechtlichen, vertraglichen oder wirtschaftlichen Folgen entstehen?
- Gibt es ein geeignetes manuelles oder alternatives Verfahren?
- Wie verändert sich die Auswirkung mit der Dauer der Unterbrechung?
- Welche Anwendungen und Daten werden benötigt?
- Wer darf den Prozess nach der Wiederherstellung fachlich freigeben?
Erst auf dieser Grundlage lässt sich eine nachvollziehbare Priorisierung erstellen.
Beispiel für eine geschäftliche Priorisierung
Die folgende Tabelle zeigt ein fiktives mittelständisches Handelsunternehmen. Sie ist ein Planungsbeispiel und stellt keine reale Kundenumgebung dar.
| Geschäftsprozess | Mögliche Auswirkung | Vorläufige Priorität |
|---|---|---|
| Auftragserfassung | Neue Kundenaufträge können nicht verarbeitet werden | Hoch |
| Lager und Versand | Bestellungen können nicht ausgeliefert werden | Hoch |
| Kundenservice | Anfragen werden verzögert bearbeitet | Abhängig von Ersatzwegen |
| Rechnungsstellung | Rechnungen können nicht erstellt werden | Abhängig von Fristen |
| Interne Berichterstattung | Auswertungen stehen vorübergehend nicht zur Verfügung | Häufig nachrangig |
Die Prioritäten müssen an die tatsächlichen Anforderungen angepasst werden.
Während eines Monatsabschlusses kann beispielsweise die Finanzbuchhaltung besonders zeitkritisch werden. In einer anderen Situation kann sie vorübergehend mit geeigneten Ersatzverfahren arbeiten.
Prioritäten sind deshalb geschäftliche Entscheidungen, die durch technische Informationen unterstützt werden.
Warum technische Abhängigkeiten die Wiederanlaufreihenfolge bestimmen
Die fachlich wichtigste Anwendung lässt sich nicht zwangsläufig als erstes System starten.
Eine ERP-Anwendung kann beispielsweise eine Datenbank benötigen. Die Datenbank läuft auf einer virtuellen Maschine. Diese wiederum benötigt verfügbare Virtualisierungs- und Speicherressourcen.
Zusätzlich können Identitätsdienste, DNS, Zertifikate und Netzwerkverbindungen erforderlich sein.
Hier muss zwischen zwei Reihenfolgen unterschieden werden:
Geschäftliche Priorität: Welche Tätigkeit muss möglichst früh wieder funktionieren?
Technische Wiederanlaufreihenfolge: Welche Komponenten müssen dafür in welcher Reihenfolge bereitgestellt werden?
Beide Perspektiven gehören in denselben Plan.
Typische technische Abhängigkeiten
| Komponente | Mögliche Abhängigkeit |
|---|---|
| ERP-Anwendung | Datenbank, Identitätsdienst, Netzwerk |
| Datenbankserver | Storage, Betriebssystem, gegebenenfalls Cluster |
| Dateiablage | Dateidienst, Berechtigungen, Speicher |
| Remote-Arbeitsplätze | Internet, VPN oder anderer sicherer Zugang, Identität |
| Lokale Fachanwendung | DNS, Zertifikate, API-Dienste |
| Telefonie | Netzwerk, Telefonieanbieter, SBC oder Cloud-Dienst |
| Reporting | Datenbank, Datenintegration, Semantikmodell |
Nicht jede Umgebung verwendet sämtliche Komponenten. Bei cloudbasierten Anwendungen können beispielsweise Teile der zugrunde liegenden Infrastruktur durch den Anbieter bereitgestellt werden.
Die Abhängigkeiten sollten deshalb anhand der tatsächlich verwendeten Architektur dokumentiert werden.
Warum ein funktionierender Server noch keine funktionierende Anwendung bedeutet
Eine virtuelle Maschine kann erfolgreich gestartet sein, obwohl der darauf betriebene Dienst noch nicht verwendet werden kann.
Möglicherweise ist eine Datenbank nicht erreichbar. Vielleicht fehlen Netzwerkrouten, Zertifikate oder Zugriffsrechte.
Deshalb darf der technische Wiederanlauf nicht allein anhand des Einschaltzustands einer Maschine bewertet werden.
Für jede kritische Anwendung sollte festgelegt sein, woran sich ihre tatsächliche Betriebsbereitschaft erkennen lässt.
Welche Dienste häufig vor den eigentlichen Fachanwendungen benötigt werden
Eine universelle Startliste wäre irreführend. Trotzdem gibt es typische Basiskomponenten, deren Verfügbarkeit vor dem Wiederanlauf abhängiger Anwendungen geprüft werden sollte.
Netzwerk und sichere Erreichbarkeit
Die benötigten Netzwerksegmente, Verbindungen und Zugriffswege müssen funktionieren.
Dazu gehören je nach Umgebung Switches, Router, Firewalls, DNS und Verbindungen zu externen Standorten oder Cloud-Diensten.
Bei einem Sicherheitsvorfall kann es allerdings erforderlich sein, bestimmte Netzwerkbereiche bewusst isoliert zu halten.
Die Wiederherstellung der Konnektivität darf dann nur nach entsprechender Sicherheitsfreigabe erfolgen.
Identitäts- und Verzeichnisdienste
Viele Unternehmensanwendungen verwenden zentrale Identitätsdienste wie Active Directory oder Microsoft Entra ID.
Wenn Benutzer, Server oder Anwendungen ihre Identität nicht überprüfen können, bleiben möglicherweise wichtige Funktionen unzugänglich.
Welche Identitätsdienste wiederhergestellt werden müssen und wie ihr Wiederanlauf erfolgt, hängt von der Architektur ab.
Bei Active Directory müssen insbesondere die von Microsoft dokumentierten Wiederherstellungsverfahren und die Integrität des Verzeichnisdienstes berücksichtigt werden.
Speicher und Virtualisierung
Wenn wichtige Server virtualisiert betrieben werden, benötigen sie geeignete Host- und Speicherressourcen.
Auch Managementkomponenten, Storage-Verbindungen und gegebenenfalls Clusterfunktionen können relevant sein.
Nicht jede Verwaltungsoberfläche muss zwingend vor jeder virtuellen Maschine laufen. Die erforderliche Reihenfolge ergibt sich aus der konkreten Plattform und ihrem Wiederherstellungsszenario.
Datenbanken und gemeinsame Dienste
Mehrere Fachanwendungen können dieselbe Datenbankplattform oder zentrale Schnittstellen verwenden.
Diese Dienste sollten vor den davon abhängigen Anwendungen auf Konsistenz und Verfügbarkeit geprüft werden.
Ein bloßer Dienststatus „Gestartet“ ist keine vollständige Funktionsprüfung.
Ein nachvollziehbares Beispiel für den Wiederanlauf nach einem Serverausfall
Ein mittelständisches Unternehmen betreibt eine Auftrags- und Lagerverwaltung auf virtualisierten Servern.
Nach einem Hardwareausfall stehen die ERP-Anwendung und die Lagerverwaltung nicht mehr zur Verfügung.
Die Geschäftsführung entscheidet, dass die Bearbeitung neuer Aufträge und der Versand besonders wichtig sind.
Die IT untersucht anschließend, welche Dienste für diese Prozesse benötigt werden.
Vereinfachte technische Abhängigkeitskette
Netzwerk und benötigte Infrastruktur → Identitätsdienste und Namensauflösung → Datenbank → ERP-Anwendung → Lager- und Versandfunktionen
Diese Darstellung ist ausdrücklich schematisch. Manche Komponenten können parallel vorbereitet werden, während andere erst nach bestimmten Voraussetzungen einsatzbereit sind.
Die technische Wiederherstellung
Zunächst wird geprüft, ob die benötigte Infrastruktur betriebsbereit und sicher verwendbar ist.
Anschließend werden Identitätsdienste und Datenbankverbindungen entsprechend den dokumentierten Abhängigkeiten bereitgestellt.
Nach einer erfolgreichen technischen Prüfung kann die ERP-Anwendung gestartet werden.
Die Lager- und Versandfunktionen werden erst freigegeben, wenn ihre Verbindung zum ERP-System und die erforderlichen Daten bestätigt wurden.
Die fachliche Abnahme
Die IT meldet, dass das ERP-System technisch erreichbar ist.
Das reicht jedoch noch nicht aus, um den vollständigen Geschäftsbetrieb freizugeben.
Eine autorisierte Person aus dem Fachbereich prüft anhand vorher festgelegter Testfälle beispielsweise:
- Können berechtigte Mitarbeiter auf die Anwendung zugreifen?
- Lassen sich vorhandene Aufträge korrekt anzeigen?
- Stimmen wichtige Datenbestände mit dem freigegebenen Wiederherstellungspunkt überein?
- Funktioniert die Übergabe zwischen Auftragserfassung und Lager?
- Können die vereinbarten Geschäftsabläufe wieder ausgeführt werden?
Erst wenn die festgelegten Kriterien erfüllt sind, wird der betreffende Prozess zur Nutzung freigegeben.
Andere Anwendungen können währenddessen weiterhin außer Betrieb sein.
Das Unternehmen ist damit möglicherweise bereits teilweise arbeitsfähig, ohne dass der vollständige Normalbetrieb wiederhergestellt wurde.
RTO und RPO richtig für die Wiederanlaufplanung verwenden
Für die Planung der Wiederherstellung werden häufig die Begriffe Recovery Time Objective und Recovery Point Objective verwendet.
Beide Werte beschreiben Anforderungen an die Wiederherstellung, beantworten jedoch unterschiedliche Fragen.
Recovery Time Objective
Das RTO beschreibt die angestrebte maximale Dauer, innerhalb der eine definierte Funktion oder ein System nach einer Unterbrechung wieder verfügbar sein soll.
Ein RTO ist ein Planungsziel, keine automatisch garantierte Wiederherstellungsdauer.
Ob es erreichbar ist, hängt unter anderem von Architektur, Personal, Ersatzressourcen, Wiederherstellungsverfahren und dem tatsächlichen Schadensszenario ab.
Recovery Point Objective
Das RPO beschreibt den maximal tolerierbaren Datenverlust, ausgedrückt als Zeitspanne.
Wenn eine Anwendung beispielsweise nur einen sehr begrenzten Verlust jüngster Transaktionen verkraftet, muss das Sicherungs- oder Replikationskonzept entsprechend ausgelegt sein.
Ein Backup vom Vorabend erfüllt möglicherweise nicht die Anforderungen eines Prozesses, der nahezu aktuelle Daten benötigt.
Warum beide Werte zusammen betrachtet werden müssen
Ein System kann innerhalb der angestrebten Zeit wieder starten, dabei aber mit einem älteren Datenbestand arbeiten.
Umgekehrt kann eine sehr aktuelle Datensicherung vorhanden sein, deren Wiederherstellung deutlich länger dauert als vorgesehen.
Ein geeignetes Recovery-Konzept muss deshalb sowohl die erforderliche Verfügbarkeit als auch den tolerierbaren Datenverlust berücksichtigen.
Die Werte sollten aus der Business Impact Analysis abgeleitet und mit den technischen Möglichkeiten abgeglichen werden.
Ohne getestete Verfahren sollte keine konkrete Wiederherstellungsdauer zugesichert werden.
Backups allein bestimmen nicht, wann ein System wieder arbeitsfähig ist
Eine vorhandene Datensicherung ist eine wichtige Voraussetzung für viele Wiederherstellungsszenarien.
Sie sagt jedoch noch nicht aus, wann eine geschäftskritische Anwendung wieder verwendet werden kann.
Dazu müssen unter anderem die Backup-Verfügbarkeit, die Integrität der Daten und die erforderliche Zielinfrastruktur berücksichtigt werden.
Welche Fragen vor dem Restore zu klären sind
Vor einer Wiederherstellung sollten die Verantwortlichen prüfen:
- Welche Systeme und Daten wurden gesichert?
- Welcher Wiederherstellungspunkt ist für den betroffenen Prozess geeignet?
- Sind die erforderlichen Verschlüsselungs- und Wiederherstellungsschlüssel verfügbar?
- Wo sollen die Daten wiederhergestellt werden?
- Sind Datenbank- und Anwendungsversionen kompatibel?
- Besteht ein Risiko, bereits wiederhergestellte Informationen zu überschreiben?
- Welche anderen Systeme greifen auf dieselben Daten zu?
Bei einem Cyberangriff ist zusätzlich zu bewerten, ob Sicherungen und Zielsysteme vertrauenswürdig sind.
Ein Backup sollte nicht allein deshalb als sauber gelten, weil der Sicherungsjob erfolgreich abgeschlossen wurde.
Wiederherstellung nicht mit Verfügbarkeit verwechseln
Der eigentliche Restore kann erfolgreich sein, obwohl eine Anwendung weiterhin nicht genutzt werden kann.
Beispielsweise könnte eine Datenbank technisch wiederhergestellt sein, während benötigte Schnittstellen fehlen oder Zugriffsrechte noch nicht korrekt funktionieren.
Deshalb sollten Wiederherstellungstests stets geeignete Anwendungstests einschließen.
Wer entscheidet im IT-Notfall über die Prioritäten?
Die Wiederanlaufplanung ist keine ausschließliche Aufgabe der IT-Abteilung.
Technische Spezialisten wissen, welche Abhängigkeiten bestehen und welche Verfahren möglich sind.
Die geschäftlichen Auswirkungen und Prioritäten müssen jedoch mit den zuständigen Fachbereichen und der Unternehmensleitung abgestimmt werden.
Rollen und Verantwortlichkeiten festlegen
Eine mögliche Zuordnung sieht folgendermaßen aus:
| Rolle | Verantwortung |
|---|---|
| Geschäftsführung oder autorisierte Notfallleitung | Geschäftliche Prioritäten und übergreifende Entscheidungen |
| Notfallkoordination | Abstimmung, Dokumentation und Eskalation |
| IT-Verantwortliche | Technische Wiederanlaufplanung und Durchführung |
| Informationssicherheit | Sicherheitsbewertung und erforderliche Freigaben |
| Fachbereich | Prüfung und Freigabe geschäftlicher Funktionen |
| Externer IT-Dienstleister | Vertraglich vereinbarte Recovery- und Unterstützungsleistungen |
| Kommunikation | Information von Mitarbeitern und gegebenenfalls externen Beteiligten |
In kleineren Unternehmen können einzelne Personen mehrere Rollen übernehmen.
Entscheidend ist, dass Zuständigkeiten und Stellvertretungen vorher festgelegt werden.
Was geschieht, wenn eine Schlüsselperson nicht erreichbar ist?
Ein Wiederanlaufplan muss auch ohne die Person funktionieren, die ihn ursprünglich geschrieben hat.
Deshalb sind Stellvertretungen und dokumentierte Entscheidungsbefugnisse wichtig.
Notfallkontakte und erforderliche Anleitungen müssen außerdem unabhängig von möglicherweise ausgefallenen Systemen verfügbar sein.
Wenn der Wiederanlaufplan ausschließlich in einer nicht erreichbaren SharePoint-Bibliothek liegt, kann das im Ernstfall zu einem zusätzlichen Problem werden.
Wie ein Wiederanlauf-Runbook aufgebaut sein sollte
Ein IT-Notfallkonzept beschreibt übergreifende Anforderungen und organisatorische Regeln.
Ein Wiederanlauf-Runbook geht einen Schritt weiter: Es dokumentiert die konkreten Handlungen, Prüfungen und Freigaben für einen definierten Wiederherstellungsablauf.
Je nach Unternehmen kann ein Runbook für eine einzelne Anwendung, eine Plattform oder eine gesamte Prozesskette erstellt werden.
Was ein einsatzfähiges Runbook enthalten sollte
| Bestandteil | Inhalt |
|---|---|
| Geltungsbereich | Betroffene Systeme und Geschäftsprozesse |
| Auslöser | Bedingungen für die Aktivierung |
| Verantwortliche | Durchführung, Entscheidung und Stellvertretung |
| Voraussetzungen | Benötigte Systeme, Zugänge und Dienste |
| Sicherheitsbedingungen | Erforderliche Prüfung und Freigabe |
| Wiederanlaufverfahren | Freigegebene technische Schritte |
| Datenstand | Geeigneter Wiederherstellungspunkt |
| Technische Tests | Verfügbarkeit, Integrität und Schnittstellen |
| Fachliche Tests | Geschäftliche Funktionsfähigkeit |
| Eskalation | Vorgehen bei Fehlern oder fehlenden Voraussetzungen |
| Abschluss | Abnahme und Übergabe in den Betrieb |
Die tatsächlichen Befehle, Systemeinstellungen und Wiederherstellungsdetails gehören in die kontrollierte technische Dokumentation.
Vertrauliche Kennwörter oder ungeschützte Zugangsschlüssel sollten nicht direkt in allgemein zugänglichen Runbooks gespeichert werden.
Wann wird ein Runbook verwendet?
Ein Runbook sollte nicht erst dann geschrieben werden, wenn bereits ein Ausfall eingetreten ist.
Es muss vorab abgestimmt und getestet sein.
Im Ereignisfall werden die vorbereiteten Schritte anhand der aktuellen Situation überprüft und von den zuständigen Personen freigegeben.
Ein dokumentierter Ablauf darf nicht blind ausgeführt werden, wenn die tatsächliche Lage wesentlich von den angenommenen Voraussetzungen abweicht.
Warum ein Cyberangriff eine andere Wiederanlaufstrategie erfordert
Ein Hardwaredefekt und ein Ransomware-Angriff können ähnliche Ausfallbilder verursachen.
Die erforderlichen Wiederherstellungsverfahren unterscheiden sich jedoch erheblich.
Bei einem Hardwareausfall kann die Wiederherstellung auf Ersatzhardware nach entsprechender Prüfung sinnvoll sein.
Bei einem Cyberangriff muss zuerst geklärt werden, ob Systeme, Konten oder Datensicherungen kompromittiert wurden.
Keine voreilige Wiederverbindung kompromittierter Systeme
Ein schneller Wiederanlauf darf nicht dazu führen, dass Schadsoftware erneut ausgeführt oder ein Angreifer wieder mit produktiven Systemen verbunden wird.
Daher können zusätzliche Maßnahmen erforderlich sein:
- Betroffene Systeme isolieren
- Angriffswege und kompromittierte Identitäten untersuchen
- Geeignete Wiederherstellungspunkte auswählen
- Vertrauenswürdige Wiederherstellungsumgebungen vorbereiten
- Zugangsdaten und erforderliche Schlüssel kontrolliert erneuern
- Wiederanlauf und Netzfreigabe sicherheitstechnisch abstimmen
Je nach Ereignis müssen außerdem Beweissicherung, Meldepflichten und rechtliche Anforderungen berücksichtigt werden.
Die genaue Vorgehensweise richtet sich nach der Art des Sicherheitsvorfalls.
Bei einem Cyberangriff gilt: Die schnellste Wiederherstellung ist nicht automatisch die sicherste.
Wann ist ein eingeschränkter Notbetrieb sinnvoller als die vollständige Wiederherstellung?
Nicht jedes Unternehmen kann nach einer größeren IT-Störung sofort zum gewohnten Betrieb zurückkehren.
In manchen Situationen ist ein kontrollierter Notbetrieb die bessere Zwischenlösung.
Dabei werden wichtige Geschäftsprozesse mit reduzierten Funktionen oder alternativen Verfahren fortgeführt.
Ein Unternehmen könnte beispielsweise Kundenanfragen über einen unabhängigen Kommunikationskanal aufnehmen, während die zentrale Auftragsverwaltung noch nicht verfügbar ist.
Solche Verfahren benötigen jedoch ebenfalls klare Regeln.
Datenkonsistenz beim Notbetrieb beachten
Werden während eines IT-Ausfalls Informationen manuell erfasst, müssen sie später möglicherweise in die produktiven Systeme übertragen werden.
Dabei können doppelte Einträge, unvollständige Vorgänge oder widersprüchliche Daten entstehen.
Deshalb sollte der Notbetriebsplan festlegen:
- Welche Tätigkeiten alternativ durchgeführt werden dürfen
- Welche Informationen dokumentiert werden müssen
- Wer neue Vorgänge freigibt
- Wie Änderungen nachvollziehbar bleiben
- Wie Daten später abgeglichen werden
- Wann der Notbetrieb beendet werden darf
Ein Notbetrieb ist kein improvisierter Ersatz für sämtliche IT-Funktionen.
Er ist ein vorbereiteter Weg, um ausgewählte kritische Tätigkeiten unter eingeschränkten Bedingungen fortzusetzen.
Wie wird der Wiederanlauf technisch und fachlich abgenommen?
Eine erfolgreich gestartete Anwendung darf nicht automatisch als vollständig wiederhergestellt gelten.
Nach der technischen Wiederherstellung muss geprüft werden, ob die vereinbarten Funktionen tatsächlich verfügbar sind.
Technische Abnahmekriterien
Zu den möglichen Kriterien gehören:
- Erforderliche Dienste sind erreichbar.
- Datenbanken befinden sich in einem geeigneten konsistenten Zustand.
- Benötigte Schnittstellen funktionieren.
- Vorgesehene Berechtigungen sind aktiv.
- Sicherheitsprüfungen wurden abgeschlossen.
- Systemprotokolle zeigen keine ungeklärten kritischen Fehler.
- Überwachung und Datensicherung sind entsprechend dem Wiederanlaufkonzept eingerichtet.
Fachliche Abnahmekriterien
Die zuständigen Fachbereiche prüfen anschließend die tatsächlichen Geschäftsabläufe.
Dazu können beispielsweise das Öffnen eines Kundenauftrags, die Bearbeitung einer Rechnung oder die Übergabe eines Versandvorgangs gehören.
Solche Tests sollten möglichst anhand vorher festgelegter Szenarien erfolgen.
Dabei muss auch bewertet werden, ob Daten aus dem Notbetrieb nachgetragen oder abgeglichen werden müssen.
Wer gibt die Anwendung wieder frei?
Die technische Betriebsbereitschaft sollte von den technischen Verantwortlichen bestätigt werden.
Ob der betroffene Geschäftsprozess mit den wiederhergestellten Funktionen freigegeben werden kann, entscheidet die zuständige fachliche beziehungsweise übergreifend autorisierte Stelle.
Offene Einschränkungen und verbleibende Risiken sollten dokumentiert sein.
Wie lässt sich die Wiederanlaufreihenfolge vor einem echten Ausfall testen?
Ein Wiederanlaufplan ist zunächst eine dokumentierte Annahme darüber, wie sich Systeme und Geschäftsprozesse wiederherstellen lassen.
Erst durch geeignete Tests wird sichtbar, ob der geplante Ablauf tatsächlich funktioniert.
Dabei müssen nicht sämtliche Systeme gleichzeitig abgeschaltet werden.
Je nach Risiko und Infrastruktur sind unterschiedliche Übungsformen möglich.
Dokumentenbasierte Prüfung
Die Beteiligten gehen den Wiederanlaufplan gemeinsam durch.
Dabei wird geprüft, ob Ansprechpartner, Systeme, Abhängigkeiten und Entscheidungswege vollständig beschrieben sind.
Eine solche Übung kann organisatorische Lücken sichtbar machen, beweist jedoch noch keine technische Wiederherstellbarkeit.
Technischer Wiederherstellungstest
In einer geeigneten, isolierten Testumgebung werden ausgewählte Systeme oder Daten wiederhergestellt.
Dabei lässt sich überprüfen, ob die dokumentierten Verfahren ausführbar sind und welche technischen Hindernisse auftreten.
Besonders bei Datenbanken und komplexen Anwendungen sollten anschließend geeignete Funktionstests erfolgen.
Umfassendere Wiederanlaufübung
Eine weitergehende Übung kann mehrere voneinander abhängige Anwendungen und die beteiligten Fachbereiche einbeziehen.
Hier werden neben der technischen Umsetzung auch Kommunikation, Freigaben und Eskalationswege betrachtet.
Umfang und Häufigkeit solcher Tests sollten sich am Schutzbedarf und den tatsächlichen Betriebsrisiken orientieren.
Testergebnisse als Grundlage für Verbesserungen
Nach jeder Übung sollten Abweichungen dokumentiert werden.
Wenn beispielsweise eine Datenbank zwar wiederhergestellt werden konnte, eine benötigte Schnittstelle aber nicht startete, gehört diese Erkenntnis in die Abhängigkeitsdokumentation.
Auch gemessene Testzeiten können hilfreich sein. Sie sollten jedoch nicht ohne Berücksichtigung der Testbedingungen als garantierte Wiederherstellungszeiten kommuniziert werden.
Welche Informationen Unternehmen vor dem nächsten IT-Ausfall sammeln sollten
Wer einen Wiederanlaufplan vorbereiten möchte, benötigt zunächst einen belastbaren Überblick über wichtige Geschäftsprozesse und ihre technischen Voraussetzungen.
Die folgende Checkliste kann als Grundlage für ein internes Planungsgespräch dienen.
| Prüffrage | Erledigt |
|---|---|
| Sind die kritischen Geschäftsprozesse bekannt? | ☐ |
| Sind die geschäftlichen Auswirkungen eines Ausfalls bewertet? | ☐ |
| Gibt es eine fachlich abgestimmte Priorisierung? | ☐ |
| Sind die benötigten Anwendungen erfasst? | ☐ |
| Sind technische Abhängigkeiten dokumentiert? | ☐ |
| Sind geeignete RTO- und RPO-Anforderungen definiert? | ☐ |
| Sind Backup- und Wiederherstellungsverfahren bekannt? | ☐ |
| Sind Wiederherstellungspunkte und Datenintegrität berücksichtigt? | ☐ |
| Sind Verantwortliche und Stellvertretungen festgelegt? | ☐ |
| Ist ein sicherer Zugriff auf die Notfalldokumentation möglich? | ☐ |
| Sind Notbetriebsverfahren vorbereitet? | ☐ |
| Gibt es technische und fachliche Abnahmekriterien? | ☐ |
| Sind die Eskalationswege dokumentiert? | ☐ |
| Wurden relevante Wiederherstellungsabläufe getestet? | ☐ |
| Gibt es einen Prozess zur Aktualisierung der Runbooks? | ☐ |
Nicht jede Organisation benötigt ein umfangreiches Dokumentationssystem.
Wichtiger ist, dass die Informationen aktuell, verständlich und im Notfall verfügbar sind.
Wiederanlaufplanung und Disaster Recovery mit network4you besprechen
Wenn geschäftskritische Anwendungen ausfallen, müssen mehrere technische und organisatorische Voraussetzungen zusammenpassen.
Die Verfügbarkeit eines Backups allein beantwortet noch nicht, in welcher Reihenfolge die Systeme wiederhergestellt werden sollten oder wann ein Fachbereich seine Arbeit fortsetzen kann.
network4you bietet Unternehmen im Raum München Leistungen rund um IT-Infrastruktur, Datensicherung und Disaster-Recovery-Konzeptionen.
Bei der Planung einer geeigneten Wiederherstellungsstrategie können die vorhandene Server- und Storage-Infrastruktur, eingesetzte Backup-Lösungen sowie die technischen Voraussetzungen der betroffenen Anwendungen betrachtet werden.
Darüber hinaus ist es sinnvoll, Anforderungen an die Wiederherstellung mit den tatsächlich kritischen Geschäftsprozessen abzugleichen.
Welche Beratungs- und Umsetzungsleistungen für ein konkretes Unternehmen geeignet sind, hängt von der vorhandenen Umgebung und den vereinbarten Projektzielen ab.
Weitere Informationen finden Sie unter Disaster-Recovery-Konzeptionen und Wiederherstellungslösungen für Unternehmen.
Wiederanlaufplanung mit network4you besprechen
Sie möchten klären, welche Systeme Ihr Unternehmen nach einem IT-Ausfall zuerst benötigt und wie die technische Wiederherstellung vorbereitet werden kann?
Besprechen Sie mit network4you Ihre vorhandene IT-Infrastruktur, die eingesetzten Anwendungen und die bisherigen Backup- und Recovery-Verfahren.
Für eine erste Anfrage genügt eine allgemeine Beschreibung der Umgebung und der wichtigsten Anforderungen. Vertrauliche Administratorkennwörter, Wiederherstellungsschlüssel oder Sicherheitsdokumentationen sollten nicht über allgemeine Kontaktformulare übermittelt werden.
Fazit – Die richtige Wiederanlaufreihenfolge macht Unternehmen schneller wieder handlungsfähig
Nach einem größeren IT-Ausfall kommt es nicht allein darauf an, einzelne Server möglichst schnell wieder zu starten.
Entscheidend ist, welche Geschäftsprozesse zuerst verfügbar sein müssen und welche technischen Komponenten dafür erforderlich sind.
Eine belastbare Wiederanlaufplanung verbindet deshalb geschäftliche Prioritäten mit technischen Abhängigkeiten.
Business Impact Analysis, geeignete RTO- und RPO-Anforderungen, dokumentierte Verantwortlichkeiten und getestete Runbooks bilden dafür eine wichtige Grundlage.
Besonders nach Cyberangriffen muss zusätzlich sichergestellt werden, dass nur ausreichend geprüfte Systeme und Daten wieder in den Produktivbetrieb gelangen.
Ein Unternehmen ist nicht automatisch wieder arbeitsfähig, weil alle Server eingeschaltet sind. Es ist arbeitsfähig, wenn die priorisierten Geschäftsprozesse sicher und nachweisbar wieder funktionieren.
Häufig gestellte Fragen zur Wiederherstellung nach einem IT-Ausfall
Welche Anwendungen sollten nach einem IT-Ausfall zuerst wiederhergestellt werden?
Zuerst sollten die Anwendungen und technischen Voraussetzungen wiederhergestellt werden, die für besonders zeitkritische Geschäftsprozesse benötigt werden. Die Reihenfolge ergibt sich aus der geschäftlichen Priorisierung und den technischen Abhängigkeiten. Eine allgemeingültige Startreihenfolge gibt es nicht.
Warum muss ein Datenbankserver manchmal vor der Fachanwendung starten?
Viele Fachanwendungen benötigen eine funktionsfähige Datenbank. Ist sie nicht erreichbar oder nicht in einem geeigneten Zustand, kann die Anwendung trotz gestartetem Server unbrauchbar bleiben. Deshalb müssen Datenbankverfügbarkeit und weitere Abhängigkeiten vor der fachlichen Freigabe geprüft werden.
Was ist der Unterschied zwischen einem IT-Notfallplan und einem Wiederanlaufplan?
Ein IT-Notfallplan beschreibt organisatorische und technische Maßnahmen zur Bewältigung eines Ausfalls. Ein Wiederanlaufplan konkretisiert, in welcher Reihenfolge bestimmte Dienste und Prozesse wieder bereitgestellt werden und wie deren Funktionsfähigkeit geprüft wird.
Was bedeuten RTO und RPO bei der Wiederherstellung?
RTO bezeichnet die angestrebte maximale Unterbrechungsdauer eines definierten Systems oder Prozesses. RPO beschreibt den maximal tolerierbaren Datenverlust als Zeitspanne. Beide Werte werden anhand der geschäftlichen Anforderungen festgelegt und müssen mit den technischen Möglichkeiten abgeglichen werden.
Reicht ein funktionierendes Backup für Disaster Recovery aus?
Nein. Neben einer verfügbaren Datensicherung werden eine geeignete Zielinfrastruktur, erforderliche Zugänge, dokumentierte Wiederherstellungsverfahren und funktionierende Anwendungsabhängigkeiten benötigt. Auch die Datenintegrität und die fachliche Nutzbarkeit müssen geprüft werden.
Wer legt die Reihenfolge der IT-Wiederherstellung fest?
Die geschäftlichen Prioritäten sollten von autorisierten Verantwortlichen gemeinsam mit den Fachbereichen festgelegt werden. Die IT ermittelt die technischen Abhängigkeiten und plant darauf aufbauend den Wiederanlauf. Bei Sicherheitsvorfällen müssen zusätzliche Sicherheitsfreigaben berücksichtigt werden.
Kann ein Unternehmen während der Wiederherstellung eingeschränkt weiterarbeiten?
Ja, wenn geeignete Notbetriebsverfahren vorbereitet wurden. Bestimmte Tätigkeiten können unter Umständen manuell oder über alternative Systeme fortgesetzt werden. Dabei müssen Datenkonsistenz, Verantwortlichkeiten und die spätere Überführung in den Normalbetrieb geregelt sein.
Wie lässt sich ein Wiederanlaufplan testen, ohne die Produktion abzuschalten?
Möglich sind dokumentenbasierte Übungen, technische Wiederherstellungstests in isolierten Umgebungen und kontrollierte Funktionstests. Welche Testform geeignet ist, hängt von den Systemen und Risiken ab. Ein rein theoretischer Test beweist jedoch noch keine vollständige technische Wiederherstellbarkeit.
Wann gilt ein IT-System nach einem Ausfall als vollständig wiederhergestellt?
Ein erfolgreich gestarteter Server allein reicht nicht aus. Die vereinbarten technischen und fachlichen Funktionen müssen verfügbar sein und die erforderlichen Sicherheits- und Datenintegritätsprüfungen bestanden haben. Die Freigabe erfolgt durch die dafür zuständigen Verantwortlichen.
Disaster-Recovery-Konzeptionen